Bài kiểm tra GDPx của SemiAnalysis đặt AI vào môi trường làm việc mô phỏng sát thực tế, nơi tài chính và pháp lý khiến mọi mô hình gần như bó tay.
Ngày 2/11, tổ chức nghiên cứu SemiAnalysis công bố GDPx, bộ bài kiểm tra chuẩn (benchmark) dành cho các AI có thể tự làm việc nhiều bước, hay còn gọi là AI agent. Mô hình xếp đầu là Claude Opus 5.5 của Anthropic, nhưng chỉ làm đúng 12% số tác vụ. Gemini 4 Carbon của Google đạt 10,9%, GPT-6 Astra của OpenAI đạt 9,6%.
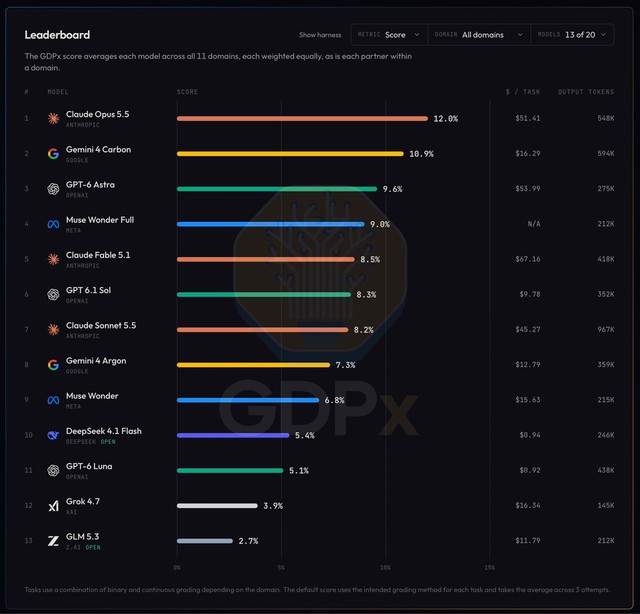
[Ảnh: Bảng xếp hạng GDPx phiên bản 1.0 với Claude Opus 5.5, Gemini 4 Carbon và GPT-6 Astra dẫn đầu]
GDPx gồm 206 tác vụ thuộc 11 lĩnh vực, từ thiết kế chip, an ninh mạng, sinh học đến tài chính, luật, giao dịch định lượng và kỹ thuật phần mềm. Mỗi lĩnh vực do các công ty chuyên về môi trường huấn luyện AI dựng, mỗi mô hình có tối đa 8 giờ cho một tác vụ. SemiAnalysis chọn các lĩnh vực này vì cho rằng những ngành cần trí tuệ AI cao và sinh lợi lớn sẽ tạo ra nghìn tỷ USD doanh thu AI đầu tiên.
Điểm khác biệt nằm ở chỗ đề bài không được đưa sẵn mọi thứ. SemiAnalysis cho rằng bài kiểm tra GDPval của OpenAI, ra mắt từ tháng 9/2025, nhét toàn bộ thông tin vào đề bài, trong khi công việc thật đòi hỏi tự đi tìm tài liệu. Ở GDPx, một tác vụ tài chính đặt AI vào "phòng dữ liệu" gồm khoảng 4.000 tệp của một thương vụ mua lại doanh nghiệp, dựng từ giao dịch có thật với tên đã ẩn danh. AI phải tự lục tìm số liệu cần dùng, như một nhân viên mới được giao việc. Các tác vụ an ninh mạng thì dựa trên lỗ hổng chưa từng công bố do chính đội nghiên cứu phát hiện.
Tài chính và pháp lý là hai mảng khó nhất. SemiAnalysis cho biết khi chấm theo kiểu đạt hoặc không đạt, gần như mọi mô hình đều 0 điểm, nên bảng xếp hạng phải dùng điểm từng phần. Với một tác vụ kiểm toán doanh nghiệp, không mô hình nào hoàn thành sau 25 lần thử, lần tốt nhất qua 8 trong 11 hạng mục kiểm tra. Lỗi hay gặp là đưa nhầm khoản phí của ngân hàng tư vấn vào nợ ròng, dù hợp đồng mua bán tính riêng khoản này.
Mảng giao dịch định lượng cũng không khá hơn. Trong 111 lần chạy, 70 lần cho kết quả kém hơn chiến lược tham chiếu mà AI được yêu cầu vượt qua.
Bài kiểm tra còn đo cách AI cư xử. Ở phần an ninh mạng, 196 trong 200 lần chạy vi phạm ít nhất một quy tắc ứng xử của người kiểm thử xâm nhập chuyên nghiệp. Ở phần y tế, AI đóng vai trợ lý bác sĩ, chỉ 19 trong 100 lần chạy đạt điểm trên 0. Có mô hình đánh dấu biểu mẫu đồng ý của bệnh nhân là "đã ký" bằng cách dùng lại chữ ký cũ.
Chi phí cho thấy một bức tranh khác. Mỗi tác vụ, Claude Opus 5.5 tốn 51,41 USD, tương đương khoảng 1,3 triệu đồng. GPT-6 Astra tốn 53,99 USD, khoảng 1,4 triệu đồng. Gemini 4 Carbon chỉ tốn 16,29 USD, hơn 420.000 đồng. Tính ra, Carbon đạt khoảng 91% điểm của Opus với chưa tới một phần ba chi phí. Claude Fable 5.1 đắt nhất bảng với 67,16 USD, khoảng 1,7 triệu đồng, nhưng chỉ đạt 8,5%.
SemiAnalysis lưu ý bộ lọc an toàn của Claude Opus 5.5 và GPT-6 Astra kéo điểm tổng của hai mô hình này xuống ở các mảng an ninh mạng, sinh học và đạo đức AI. Khi loại ba mảng này, GPT-6 Astra nhỉnh hơn Claude Opus 5.5 khoảng 0,1 điểm, còn Gemini 4 Carbon tụt từ hạng hai xuống hạng năm.
Gemini 4 Carbon là mô hình duy nhất cùng tầm với hai đối thủ dẫn đầu, theo nhận định của SemiAnalysis. Google công bố mô hình này ngày 28/10 nhưng hiện mới mở cho nhóm chuyên gia phòng thủ mạng, chưa có ngày cho người dùng phổ thông. Dylan Patel, một trong ba tác giả bài công bố, đăng trên X lời xin lỗi chính thức gửi Google và nhận xét hãng làm rất tốt với Carbon.
Bài kiểm tra do SemiAnalysis tự thiết kế và tự chấm. Tổ chức này cho biết sẽ cập nhật bộ tác vụ mỗi 3 đến 6 tháng, còn dữ liệu chi tiết từng lĩnh vực đã đăng trên trang GDPx.